读文献时不要做笔记:保持思维流动性与母子知识树的构建范式
在学术研究中,阅读前沿文献是一项高密度的认知活动。
许多学者在精读长篇论文时,往往习惯准备一个空白笔记本或文档窗口,一边阅读、一边摘抄、一边记录思考。然而在真实的科研场景中,这种“边读边记”的习惯往往会带来严重的体验卡顿:每阅读一段公式推导或实验分析,就要停下来切换到笔记窗口敲击键盘;而当记录完毕重新回到论文中时,之前在脑海中建立的复杂上下文与推理脉络往往已经中断,不得不重新从段落开头扫读。
最终的结果是:阅读节奏被频繁的记录动作反复撕扯,阅读体验“一卡一卡的”,耗费了大半天时间却迟迟无法通读一篇论文。
读文献最核心的诉求,在于完整把握论文的逻辑脉络,并在通读之后沉淀出属于自己的关键知识体系。本文将系统阐述如何打破传统做笔记带来的认知打断,依托划词高亮、对话上文与后问对位、知识调解子对话以及 Markdown 母子文档架构,实现高度连贯的学术阅读与知识网络构建。
一、思维流动性与“边读边记”的认知冲突
认知心理学研究表明,人类在处理复杂的数理逻辑、算法架构或实验设计时,工作记忆(Working Memory)的容量极其有限。深入理解一篇论文需要读者进入高度专注的“思维流动状态”(Flow State)。
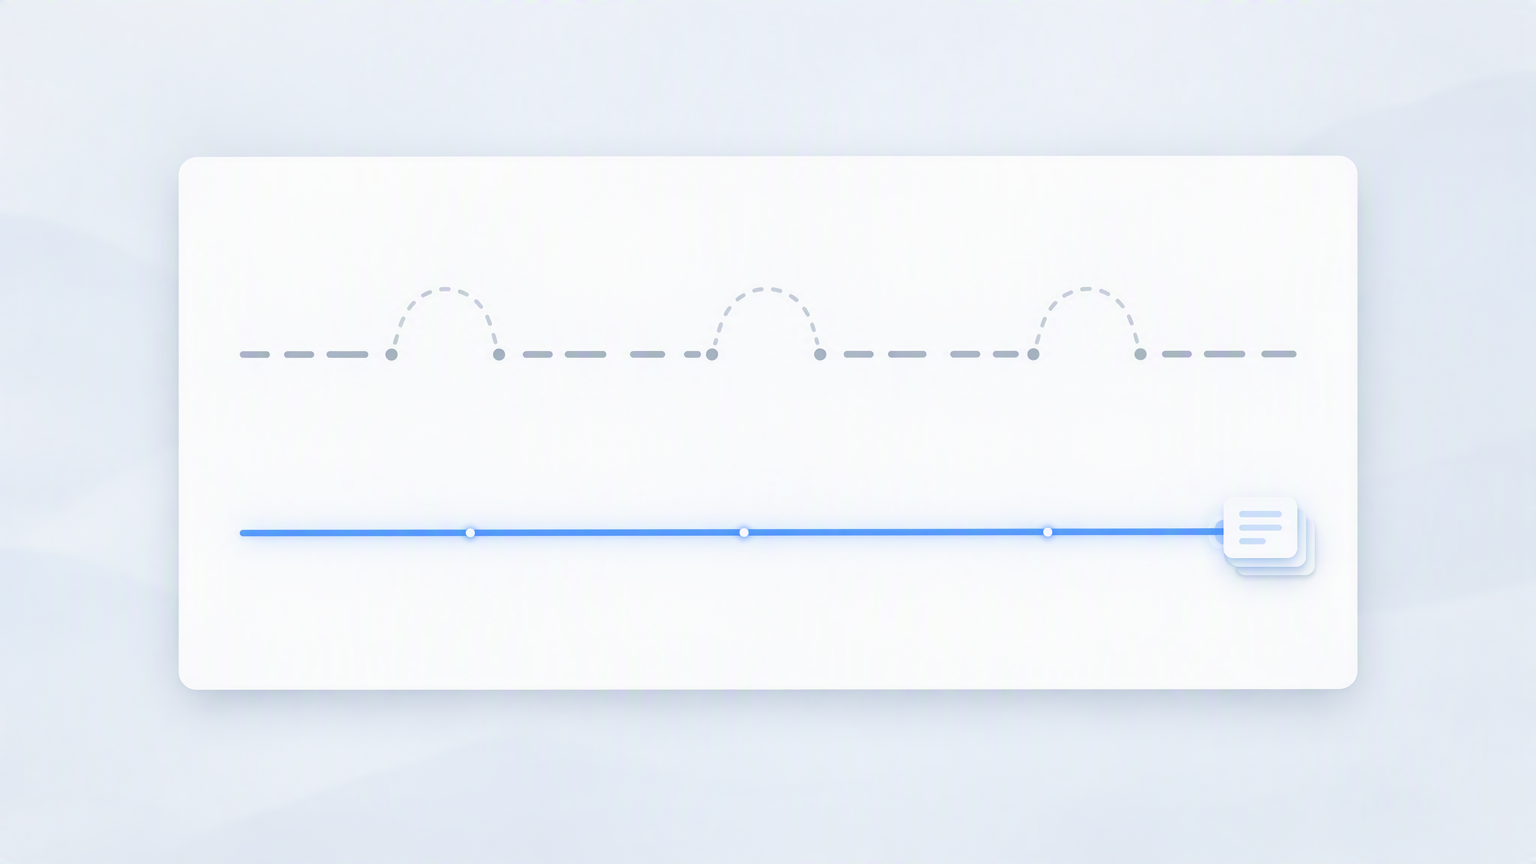
上图对照了两条阅读路径。上方一条是“边读边记”的真实状态:每读完一段就要绕出去写一次笔记,注意力沿途反复断开,重新回到正文时还得倒回段首重读,整条路径被切得七零八落。下方一条是流动阅读:全程只在正文上留下少量轻量标记,思维脉络一次性推到底,直到读完才统一沉淀为笔记。
一旦在阅读过程中插入“打字、排版、归纳、整理”等高阻尼的机械操作,读者的关注焦点就会被迫在“理解论据”与“组织笔记语言”之间频繁横跳。这种切换不仅大幅增加了心智负荷,更会导致阅读效率大幅滑坡。
因此,更高效的科研阅读范式是:在阅读阶段彻底放下做完整笔记的执念,最大限度保障阅读的流动性与连贯性。
- 极轻量的即时动作:在阅读过程中,遇到关键结论、存疑公式或启发性数据,仅执行极轻量的划词高亮,或者随手附带一行短小的批注;
- 延时性的系统归纳:保持注意力持续跟随机理推演,直至读完完整章节或全篇论文;
- 一键提取与知识聚合:在通读之后,利用“提取高亮”机制,将所有标记的原句与短注一次性结构化送入输入框,让智能体协助统筹总结出逻辑严密的阶段性学术笔记。
二、消除交互摩擦:视野守护与对话上下文对位
在借助通用大模型辅助阅读文献时,除了笔记行为本身带来的干扰,传统交互界面的粗暴设计也经常打断读者的思考链路。
1. 传统对话界面的“强制贴底”破坏阅读视野
在市面上绝大多数通用 AI 聊天界面中,存在一个极其破坏阅读连续性的默认行为:只要输入框发送消息,界面便会强行将视口机械滚动至屏幕最底部。
在学术精读场景下,这种逻辑是完全错误的。用户在向 AI 发送新的提问时,其视线往往正停留在上方某一段关键的长回答、或者刚刚生成的长篇对比分析中。传统的强制贴底滚动,会把读者正在细看的段落瞬间拉出视口,迫使读者停下手头工作,手动往上滚动数百像素去重新寻找刚才看到的位置。
成熟的科研阅读系统必须建立精细的视口锚定机制:在用户视线停留于历史内容时,绝不因后台生成而抢夺阅读视口,守护学术推导的视觉与心智焦点。
2. 同一条对话里,上文与后问要对得上
隔天重新打开一场精读对话时,常见的卡点发生在同一条对话的前后文之间。
上一轮里,智能体往往已经给出一条较长的回答,里面并列写了第一点、第二点、第三点。读的时候,这三点各自都值得再问清楚,于是研究者把它们分别选出来,在当前这场对话里接着发出问题 A、B、C。对话继续往下走之后,屏幕上最先映入眼帘的,是后面那三条新解答。当时选中的上文已经滚出视口,A、B、C 分别对着前面哪一点,隔夜就对不上了。
LightRead 把这次划选留在对话里,形成可以往返的两条痕迹:
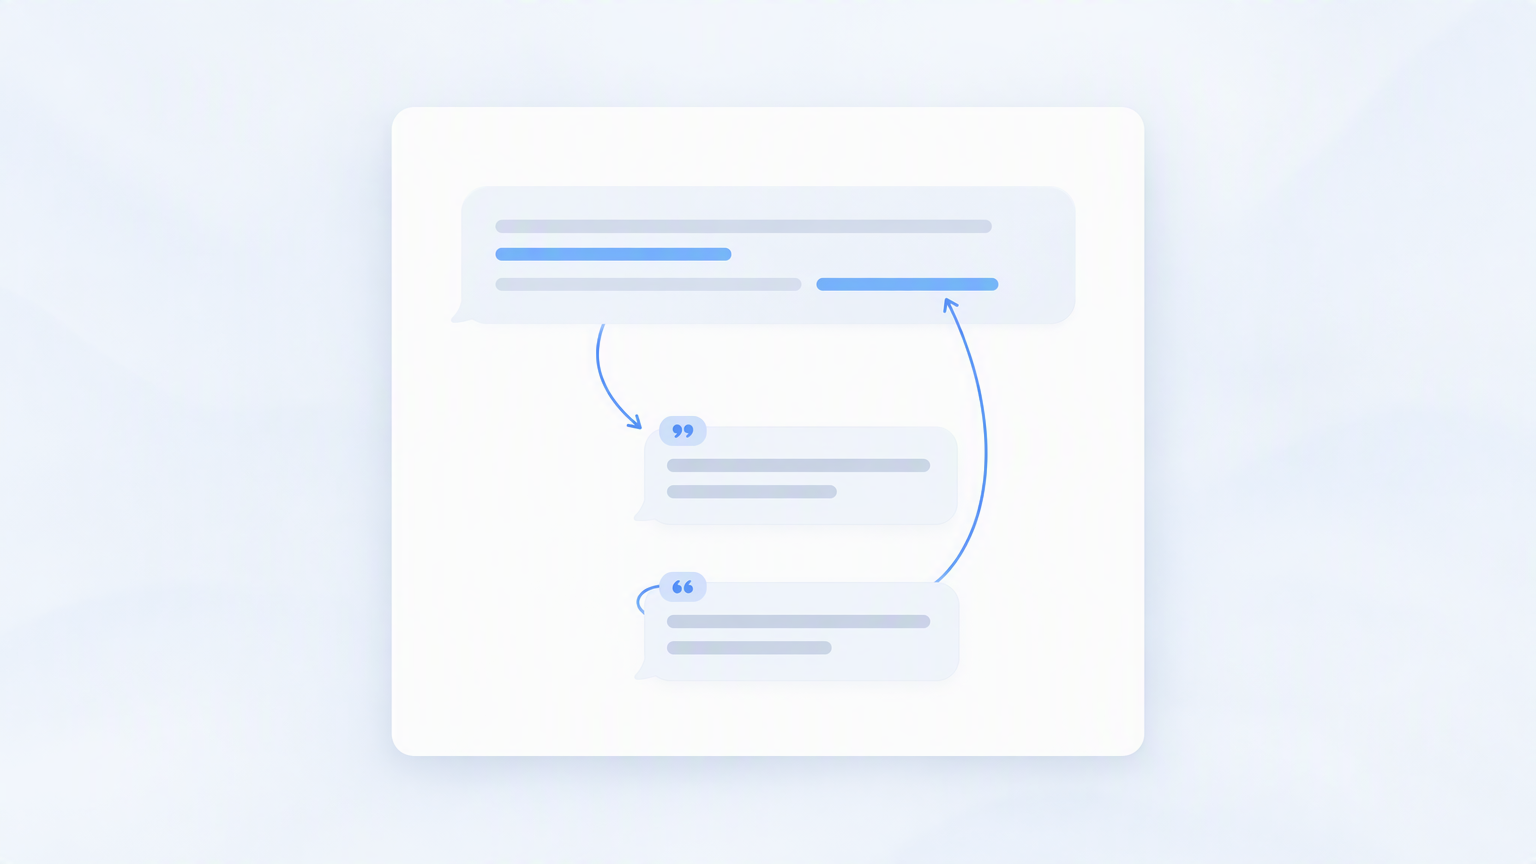
- 提问时带上上文:针对前面回答里的某一点划选并发出后问,输入框会留下一颗上文引用胶囊。事后在后问上右键这颗胶囊,视口回到当时划选的那一段,不必在几十轮消息里手工翻找。
- 上文留下下划线:被选来提问的那几句,会在原来的回答上留下下划线。右键这道下划线,对话滚到对应的后问解答处。
- 一对多仍然可分清:前面一条回答里的三点,分别对应后面的 A、B、C 时,三条下划线与三颗胶囊各自成对,回忆时按痕迹跳,不必凭印象去猜。
这样,读到后面的解答时能回到当时的提问依据,看到前面的下划线时也能落到后来的展开,同一场对话里的上下文可以快速对位。
三、多维灵感释放与知识调解子对话
在学术精读过程中,人类的思维并非单线推进,而是呈现出高度跳跃的分形特征。读到某个前沿实验设计时,研究者脑海中可能会在几秒内同时涌现出三四个关联或独立的疑问。针对这种高并发的思维跃迁,系统提供了多层级的承载机制。
1. 发送队列(Prompt Queue):释放瞬时心智负荷
当多个灵感与质疑并发涌现时,研究者无需停下来苦苦等待智能体逐字输出完毕,也不必自备草稿纸记录灵感。通过发送队列机制,研究者可以一口气将三四个疑问连续填入输入框并提交。
智能体会在后台按照严格的时序与因果依赖自动排队推演。研究者在释放完瞬时记忆负担后,可以立刻回归正文继续阅读,由智能体在后台静默推进解答。
2. 知识调解子对话(Sub-conversation):保持主线整洁
如果对论文中出现的某一个局部生僻概念(例如特定激活函数、复杂的张量切片操作或非标准评估指标)产生困惑,将其直接抛入主对话往往会带来严重的内容污染,导致主线学术讨论被大篇幅的旁支概念解释所冲淡。
此时的最佳实践是划词发起“AI 提问”。
在系统架构中,AI 提问的本质不是创建一个平行的对话实体,而是一个专注局部概念消歧的“知识调解窗口”:
- 聚焦局部消歧:子对话专用于临时、快速、单点透彻地理解某个局部观点或技术名词;
- 原文保留锚点:发起提问后,原句自动打上高亮标签。无论何时点击该标签,均可随时重新唤出该子对话面板;
- 递归分支能力:如果在子对话的解答中又遇到了更底层的概念盲区,依然可以在子对话内继续划词派生“孙子级”子对话,使思维探究如同树木生根般自然延展。
四、从认知树到知识树:Markdown 母子文档架构
随着多层级子对话的推进,一个棘手的新问题随之产生:如果为每一个子对话都手动创建一篇独立的新文档,整个知识库就会迅速碎裂为海量彼此孤立的杂乱碎片;反之,若把所有子对话中的分支定义(例如把 Attention 的起源、公式推导、历史沿革全部硬塞进讲解 Cross-Attention 论文的笔记里),又会造成主干笔记极度臃肿、反客为主。
论文所承载的认知结构,本质上是一棵自顶向下的知识树(Knowledge Tree)。在文档工程层面,必须采用与认知模型完全同构的 Markdown 母子文档架构。
1. 母子文档的职责分工与解耦
| 层次类型 | 承载对象 | 典型内容定位 | 维护原则 |
|---|---|---|---|
| 母文档(Parent Document) | 论文核心主干与全局演进脉络 | 本文的核心问题、方法假设、系统架构、实验结论与批判思考 | 保持主线清晰,不展开常见基础概念的冗长定义 |
| 子文档(Child Document) | 独立于本文的分支技术实体 | 例如特定框架(TensorFlow)、底层机制(Self-Attention)、特定数据集(ImageNet) | 独立封装为专门词条,可被当前项目其他文献复用 |
以研读《Cross-Attention is All You Need》为例:母文档专注于作者如何通过局部参数调优达到全量微调效果的逻辑论证;而论文中提及的 Transformer 基础注意力机制,则由智能体自动沉淀为名为 Self-Attention 机制原理解析.md 的独立子文档。
2. Markdown 渲染器的嵌入与深层探测(Deep Probing)
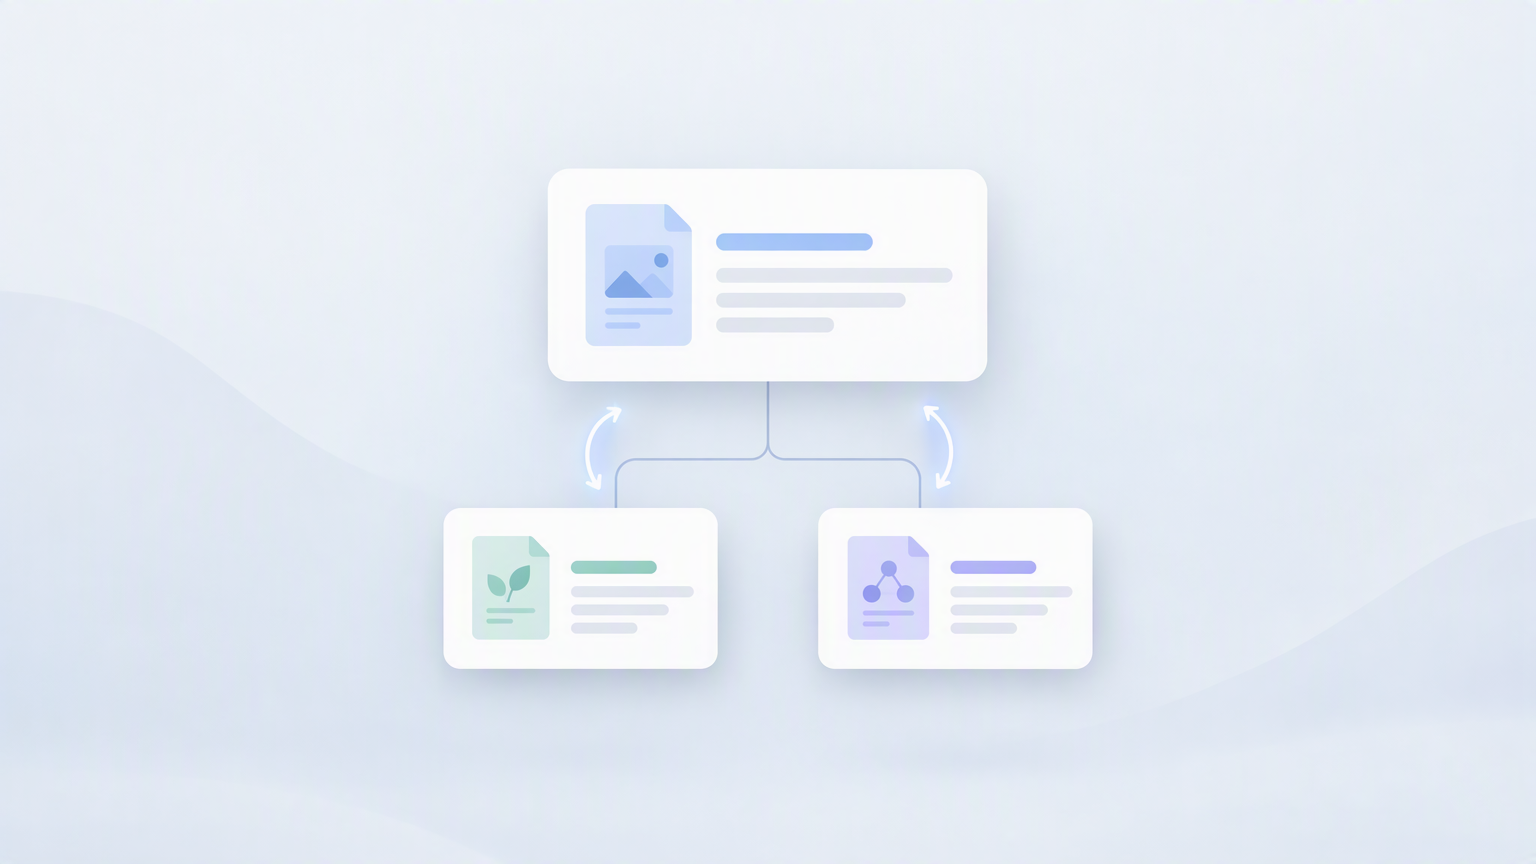
为了让树状知识结构具备极佳的可读性,系统在 Markdown 渲染引擎层面进行了专门优化:母文档正文里不再塞进一整段分支概念的定义,而是在相关句子旁嵌入一张子文档卡片。
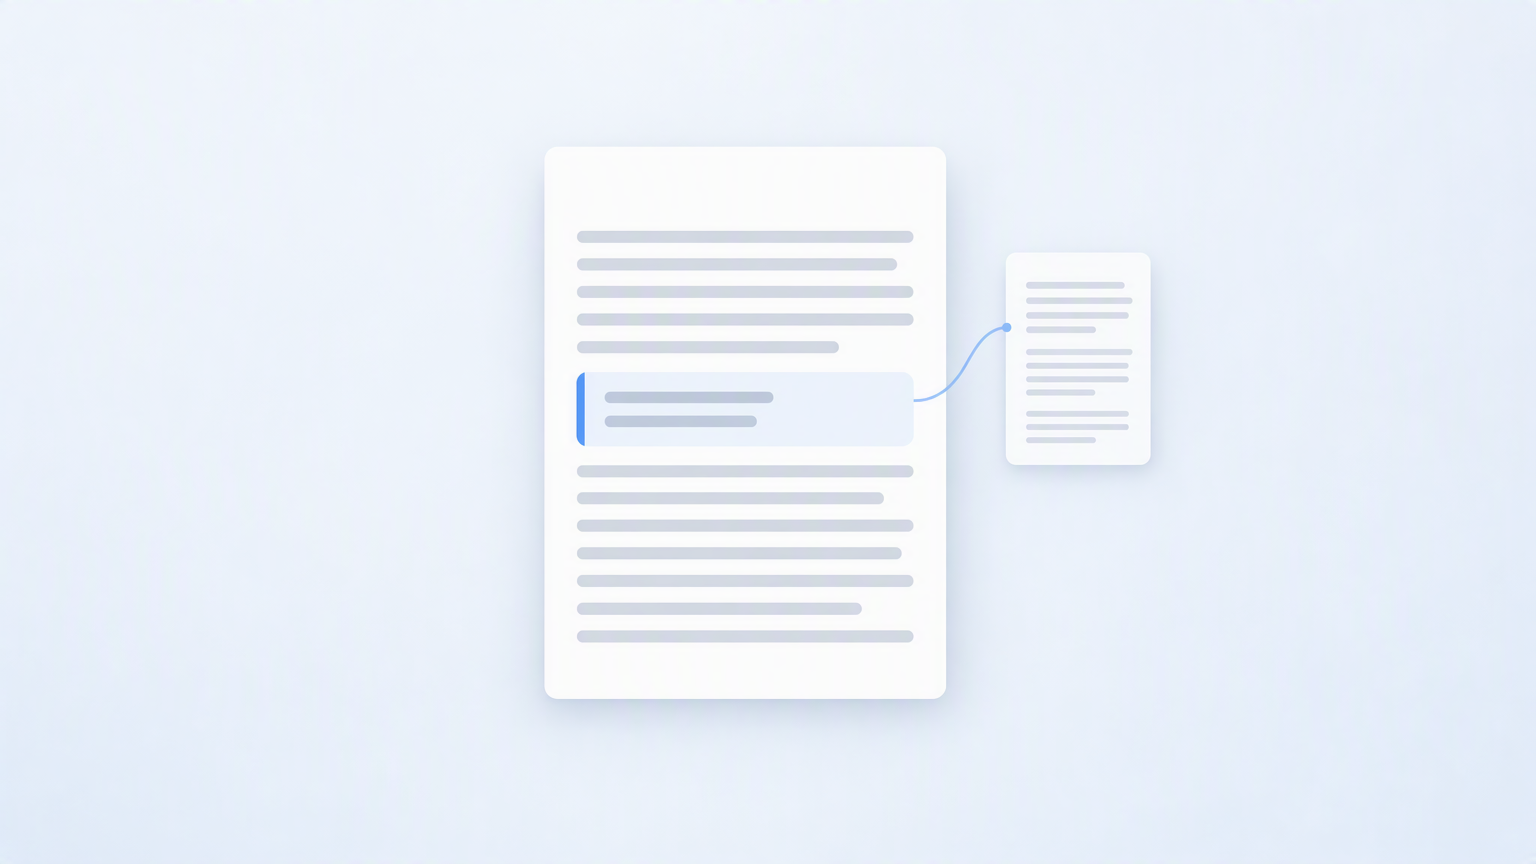
以《Cross-Attention is All You Need》的笔记为例:母文档写到「微调参数被严格约束在跨模态交互区域」时,旁边会挂出「Self-Attention 机理解析」这张卡片。读者点击卡片即可打开独立词条,不必把注意力机制的全部推导硬塞进这篇论文笔记里。
- 阅读端极速穿透:读者在阅读母文档时,面对分支概念只需点击卡片即可就地展开子文档进行查阅,复习时一目了然;
- AI 检索的多跳深层探测(Deep Probing):当用户或智能体后续在项目中检索某一特定技术方案时,AI 可以顺着母子文档的引用链接做自适应的多跳下钻,按需读取特定子文档的细节。这不仅有效保护了大模型的上下文窗口,更彻底杜绝了单篇长文档带来的噪声干扰与幻觉生成。
五、跨层级全量高亮抽取与系统化知识网络编织
母子对话与母子文档的架构设计,最终在知识沉淀阶段形成了强大的合力。
在阅读与探索的整个生命周期中,研究者无论是在主对话中、在局部的知识调解子对话中、还是在更深层的嵌套对话中,都可以随时进行轻量的高亮标记与随笔批注。
当整篇论文研读完毕,研究者在主对话中触发“提取高亮”时,底层的提取引擎并不会仅局限于当前的主窗口,而是会递归穿透并全量抽取母对话、全部子对话以及孙子嵌套对话中的所有高亮与批注数据。
以研读《Cross-Attention is All You Need》为例,一次提取实际汇拢的内容分布在三个层级:
| 层级 | 来源对话 | 被抽取的高亮与批注 |
|---|---|---|
| 主线 | 论文主对话 | 「微调 cross-attention 这一小块参数即可媲美全量微调」——批注:核心结论,需核对小样本场景下的鲁棒性 |
| 二级 | 子对话「Attention 参数解构」 | 「BitFit 与单语 Adapter 的参数更新拓扑比较」——批注:参数高效微调早期演化线索 |
| 三级 | 孙子对话「LoRA 矩阵分解」 | 「低秩分解在残差分支的梯度回传机制」——批注:可用于改进自身模型微调脚本 |
智能体接收到这一份包含主线脉络与所有旁支思索的完整树状语料后,会自动执行两项关键操作:
- 宏观统筹与脉络重构:将零散的批注按照学术逻辑重新梳理为系统性笔记,既涵盖主线方法论,又包容分支技术辨析;
- 智能插入文档双向链接:分析当前笔记与项目中已有知识库的关联,自动生成母子文档结构,并将子文档的链接卡片精准回填到母文档的对应位置。
六、总结
学术文献的阅读质量,决定了科研工作的起点与高度。
传统的阅读方式试图在阅读进行的同时完成庞大的笔记整理,其代价是牺牲了宝贵的认知流动性,陷入“一边读、一边断、读不下去”的恶性循环。
高效的科研阅读范式,应当是一场轻装上阵的流动探索: 在阅读主路径上保持轻量划词与思维专注;在交互层面依赖视口保护、上文胶囊与下划线跳转消除摩擦;在概念卡点上借助知识调解子对话分治探索;在知识沉淀阶段依靠母子文档同构与全量高亮抽取完成深度综合。
让专注的归专注,让架构的归架构——这正是数字化时代高水准科研工作流应当具备的严谨姿态与系统秩序。