Introducing LightRead 2.0:从单点对话走向可递归集群与异步科研执行
今天,我们正式向所有研究者发布 LightRead 2.0。
关于如何将多端物理设备、本地受限浏览器与 Zotero 文献库接入同一场研究对话,我们在架构解析文章 LightRead 怎样同时连上电脑、浏览器和文献库 中已作系统阐述。本文将聚焦于 LightRead 2.0 的底层系统架构:长程科研任务的动态分解、递归执行与非阻塞异步协同机制。
在过去很长一段时间里,市面上的 AI 科研工具大多停留在一个直观的形态——单线即时对话框(Single-Turn Synchronous Chat)。你输入一段提示词或上传一篇 PDF,模型在数秒内流式返回摘要或解答。对于日常浅层的快速答疑,这种模式确实足够轻量;但一旦置于严肃科学研究的真实场景——例如完成系统性跨学科开题调研、对上百篇权威文献做全景对比、在沙盒中闭环复现算法代码,抑或是完成符合出版规范的学术长篇成稿——单线对话框的局限便暴露无遗:
- 单线程同步阻塞(Synchronous Blocking Deadlock):模型处于串行输出中,人必须在浏览器前同步等待;一旦网络波动、页面刷新或任务耗时较长,整个对话与执行上下文就会中断。
- 狭窄的局部收敛(Narrow Cognitive Tunnel Vision):主流的“深度研究(Deep Research)”容易演变为沿着单一线索不断深入,容易陷入局部的先验假说,缺乏跨学科、跨领域的横向全景视野。
- 工具与数据孤岛(Execution Silos):文献检索、精读分析、本地终端运行与成稿排版完全割裂,学者被迫充当不同软件之间机械搬运数据的中介。
LightRead 2.0 的核心使命,就是彻底打破这堵墙。
在 LightRead 2.0 中,我们打造了一个在专属云电脑上独立运行的严肃科研执行系统。更重要的是,我们引入了三项重塑科研工作流的核心架构:Agent Swarm(可递归智能体集群)、Wide Research(宽广研究) 与 Async Research(异步研究与弹性接续)。
1. 异步智能体集群(Async Agent Swarm):可自适应递归演化的分布式拓扑
很多所谓的多智能体(Multi-Agent)系统,仅仅是在提示词中静态声明几个角色(比如“你是审稿人”、“你是程序员”),然后按固定管道轮流传话。这种静态机制在面对真正复杂的科学探索时,容易僵化且难以应对多变的支线。
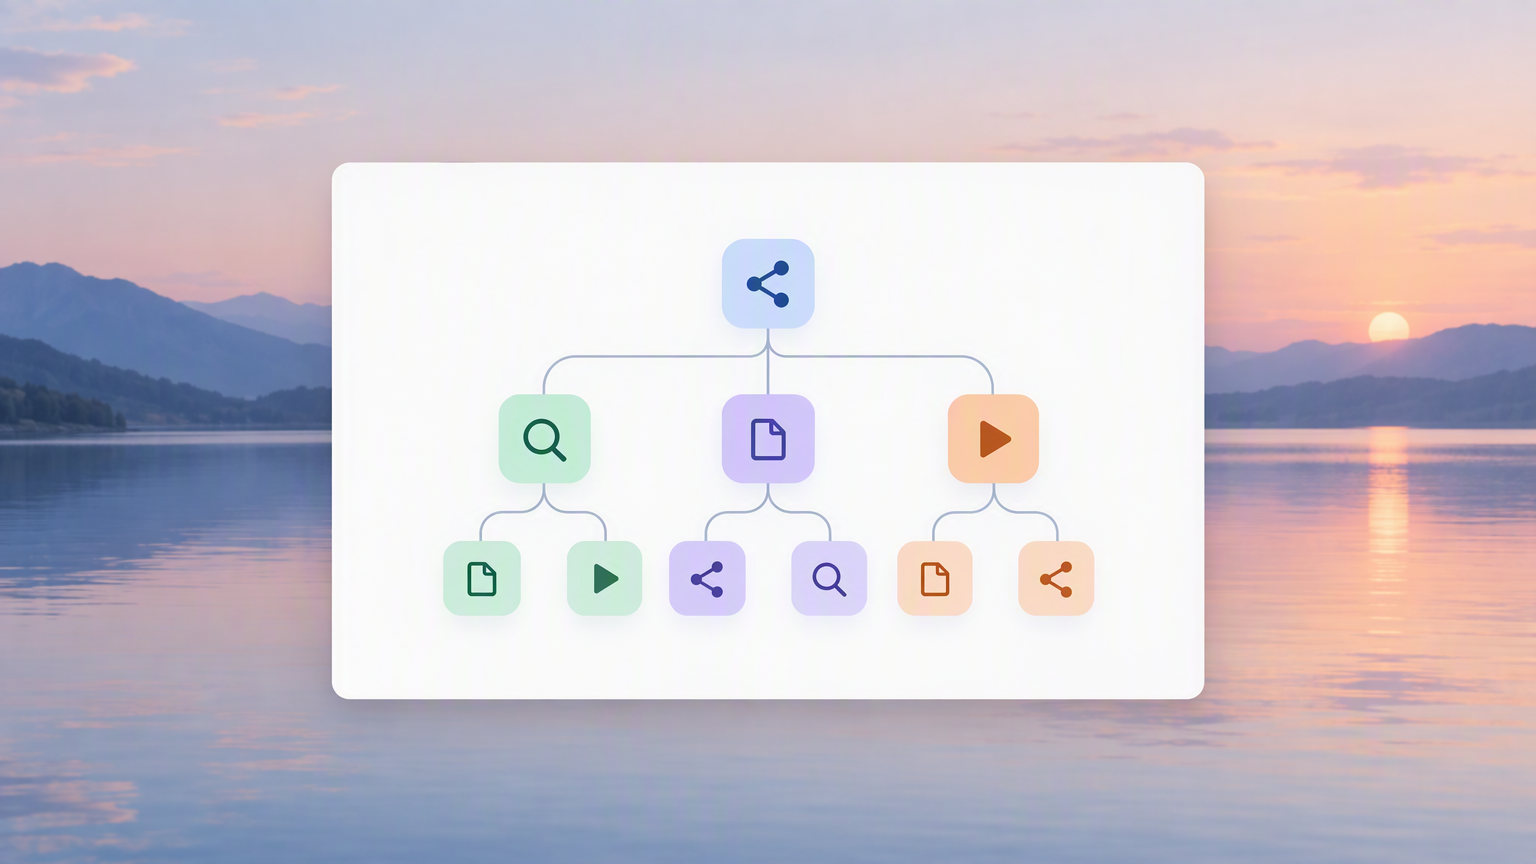
在 LightRead 2.0 中,我们称之为 异步子代理(Async Subagents) 与 可递归智能体集群(Async Agent Swarm)。它是一套根据任务需求动态演化的自适应分治架构。
其标准的执行流程包含五个核心阶段:
- 全局目标分解(Root Planner):主 Agent 将宏观科研任务拆解为执行树,明确各分支的任务边界与依赖关系;
- 多路并行派发(Parallel Dispatch):将文献检索、方法分析、数据处理与代码复现等独立任务,并行分发至各个异步子代理;
- 子任务动态递归(Self-Recursion):当某个子任务复杂度依然较高时,子代理可进一步向下递归派生更细粒度的下级 Agent,深入具体数据源(如知网、arXiv)与执行环境独立完成;
- 逐层汇总与状态回传(Layered Return):子代理执行完毕后,产出的分析结论、结构化数据与运行日志沿调用链逐层回传;
- 异步唤醒主 Agent 继续推进(Main Wakeup):关键依赖结果交付后,系统自动异步唤醒主 Agent 工作线程,进一步推进后续论证与任务闭环。
1.1 自适应递归展开(Adaptive Self-Recursion)
科研探索往往伴随着深度的支线任务。主 Agent 接收到复杂课题后,会根据任务复杂度动态展开:
- 按需向下递归:如果一个子任务依然庞大(例如“对 30 篇高引论文的关键公式和实验参数进行横向归一化提取”),负责该任务的子代理可以进一步递归派生出下级子代理,形成自适应的执行树;
- 独立的上下文与执行沙箱:派生出的子代理拥有独立的上下文窗口和运行沙盒,既不会挤占主线程的上下文,又能深入垂直领域把细节彻底做透。
1.2 对抗校验与反思闭环(Adversarial Verification)
集群内部集成了对抗校验机制。异步子代理产出的实验代码、公式推导或文献综述,在交付给主 Agent 之前,会经过独立的审阅节点进行交叉核验,主动识别不确定性并自动回溯修正,从架构层面抑制模型幻觉。
结合系统长程学习机制,集群还会从研究者的批注交互、论文收藏与方法偏好中持续提炼先验,让整个智能体团队更契合学者的研究范式与学术品味。
2. Wide Research:打开宽广的科研全景视界
在学术研究中,“Deep Research(垂直深钻)”固然重要,但方向性的路线误判往往比局部的执行缓慢更致命。如果在选题阶段没有察觉到相邻学科早已存在成熟优雅的解决范式,极易在已被解决的问题上重复摸索。
这就是为什么 LightRead 2.0 提出了 Wide Research(宽广研究 / 宽域研究)。
Wide Research 的系统哲学是:在深入垂直细节之前,先以高吞吐并发能力横向测绘出技术与文献的全景图谱,发现跨学科的交叉点,建立全局的科学罗盘。
Wide Research 的四大核心应用场景
① 跨学科灵感迁移与交叉求证(Cross-Domain Synthesis)
颠覆性的理论突破往往诞生于学科交叉的边界:
- 如何将计算机视觉最新的连续扩散模型(Diffusion Models),横向迁移至气象动力学中的强对流降水临近预报?
- 如何将自然语言处理中的**多尺度注意力(Hierarchical Attention)**机制,迁移应用于结构生物学中的蛋白质-配体结合位点预测?
Wide Research 能并发横跨计算机科学、地球科学、生物物理等异构学术数据库,自适应抽取出底层的同构方法论,为学者定位跨领域的破局切入点。
② 开题路线的多假设并行推演(Multi-Hypothesis Parallel Exploration)
在确立技术路线前,最忌讳基于局部经验过早收敛。通过 Wide Research,智能体集群可同时对多个潜在技术假设进行并行推演:
- 假设路径 A 的理论性能上界与计算复杂度如何?
- 假设路径 B 在现有公开基准数据集上的可复现性与工程鲁棒性如何?
- 假设路径 C 是否存在未披露的假设前提或知识产权冲突?
短时间内,系统即可输出涵盖理论完备性、复现成本与潜在瓶颈的多路线综合评估矩阵。
③ 百篇级高通量文献全景筛查与元分析(High-Throughput Meta-Screening)
传统即时对话系统难以承受大规模文献吞吐。Wide Research 能够并发调度集群节点,吞吐 100+ 篇核心论文,按照标准维度矩阵(研究假设、模型架构、测试环境、量化指标、消融结论与显式局限)自动化提取结构化数据,生成全景文献测绘地图。
④ 权威顶会与本土文献生态的全域穿透
无缝打通 知网(CNKI)、万方、arXiv、PubMed、IEEE Xplore、ACM DL 等中英文权威数据源。既能追踪昨晚刚刚公开在预印本平台的 SOTA 模型,又能兼顾国内核心期刊上的产业落地与真实工程实测数据,全面消除学术信息盲区。
3. Async Research:事件驱动与非阻塞异步执行
这是 LightRead 2.0 在工程架构与交互体验上的核心突破。
在传统的人机交互中,“同步等待”会带来极高的等待成本。发起复杂的分析任务后,用户不能关闭网页,稍有网络波动任务就可能中断。
Async Research(异步研究) 将科研交互从“脆弱的即时问答”转变为事件驱动、非阻塞、长程自主推进的异步系统。
3.1 既是规划者(Planner),也是执行者(Executor)
在 LightRead 2.0 中,主 Agent 拥有双重角色:
- 全局规划(Planner):统筹全局,将研究蓝图拆解为带有依赖关系的执行流程;
- 核心论证(Executor):聚焦于关键的学术推理、框架设计与阶段性结论撰写,保证研究产出的逻辑一致性。
3.2 耗时任务的非阻塞剥离(Non-Blocking Delegation)
主 Agent 在推进过程中,会将高耗时、重 I/O 的任务(例如批量下载并解析数十篇 PDF 全文、在后台沙盒运行仿真脚本、抓取整理公开实验日志),直接剥离并分发给异步子代理,在专属云端沙盒中独立推进。
主 Agent 派发完后无需原地等待,可以立即并行撰写方法学章节、推导后续假说,彻底避免了等待造成的效率停滞。
3.3 事件驱动的双向唤醒(Bidirectional Event-Driven Wakeup)
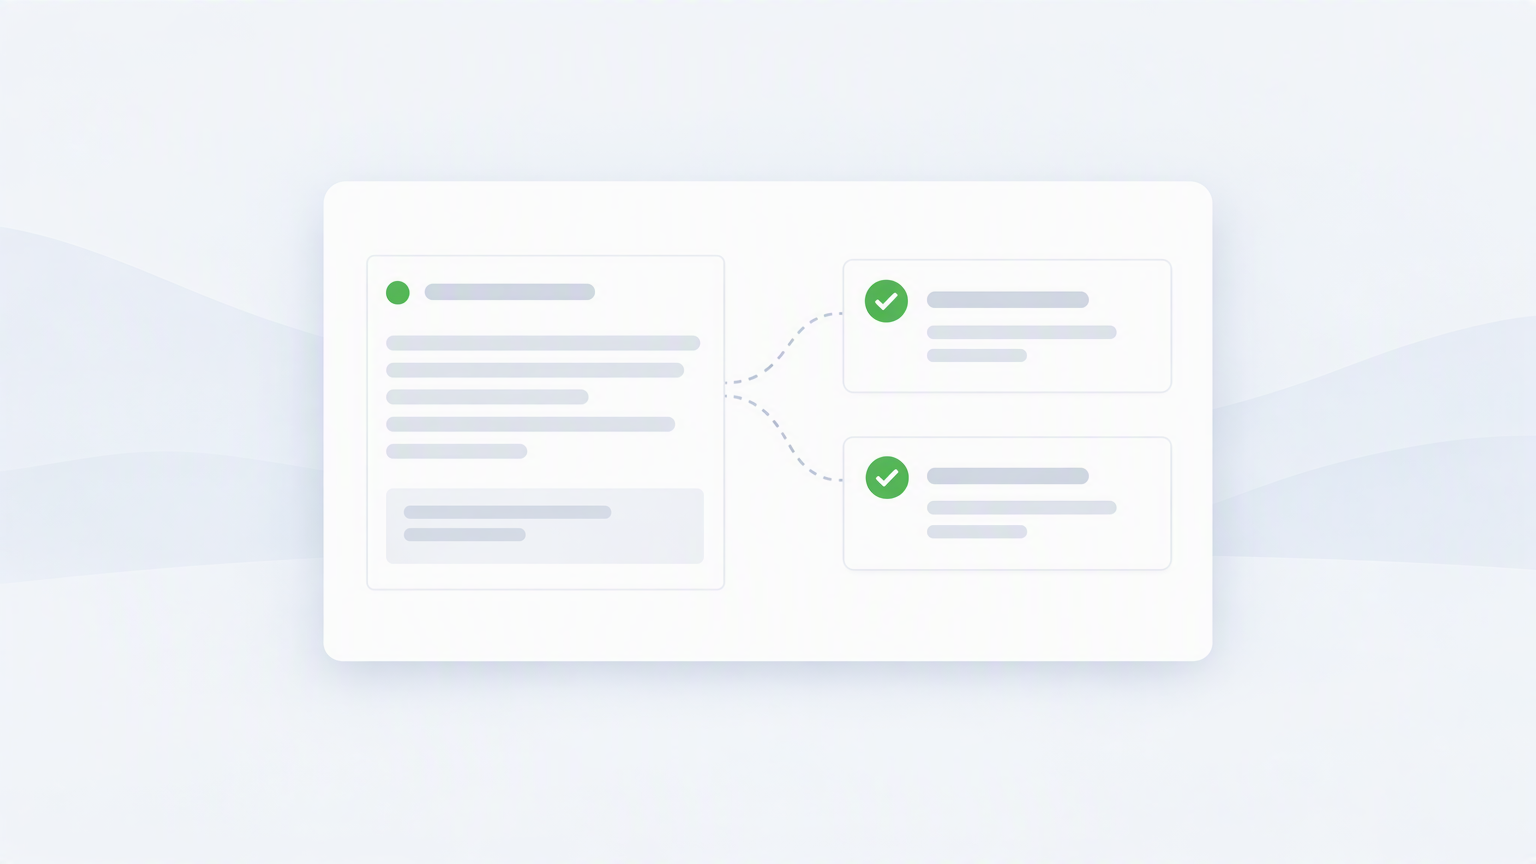
异步子代理执行完毕后,不需要系统频繁轮询,而是将生成的结构化数据、运行日志与图表产物落盘保存,并主动向主 Agent 发起就绪唤醒事件。
3.4 优雅的任务接续与产物汇总(Resilient Continuation & Synthesis)
如果在子代理完成的瞬间,主 Agent 正在专注于手头的论证撰写,系统遵循非抢占原则,绝不打断当前思考:
- 状态缓冲:子代理的产出成果在持久化队列中安全就绪;
- 安全节点触发:一旦主 Agent 推进完当前段落(进入就绪/等待状态),系统自动触发接续逻辑;
- 结构化汇总:主 Agent 读取子代理的产出,将并行的实验数据、文献分析与高清图表顺畅融入主线任务,闭环推进至最终成稿。
3.5 关掉网页,任务在专属云电脑上持续执行
整套系统依托于云端独立的运行时与专属云电脑,你可以随时合上电脑、关掉浏览器。任务在后台持续推进,当下一次重新打开 LightRead 时,结构规范的开题报告、带矢量公式与图表的学术演示稿、或是跑通的实验分析代码,已经在工作区中准备就绪。
4. 典型科研范式与工程实践(Canonical Research Paradigms)
为了便于研究者将上述架构能力投射至日常科研实践中,我们总结了三类最具代表性的端到端科研工作流:
范式一:【跨学科开题全景图】基于 Wide Research 的高吞吐假设推演
- 高阶任务指令示例:
“请以‘基于大模型推理的自动化学合成路径逆合成’为题,启动 Wide Research。结合近两年顶会预印本与国内核心期刊,推演 3 种可行的技术路线,并按基准数据集、模型计算复杂度与复现成本输出多维对比矩阵。”
- 底层执行流: 主 Agent 解构生成多分支检索拓扑,分派多路异步智能体分别下钻化学生物学数据库与计算机顶会文献;数分钟内完成数据提取与矩阵对齐,系统化指出各路线在动力学假设与数据稀疏性上的潜在缺陷。
范式二:【长篇文献综述精读】基于 Agent Swarm 的分布式协同与归约
- 高阶任务指令示例:
“从我的文献库或知网检索 50 篇关于‘具身智能机器人在未知环境下的语义导航’文献,启动异步智能体集群,按环境表征、导航策略、避障算法三大板块并行提炼,最终整合为结构严谨的文献综述,所有论断必须带有精确页码级证据索引。”
- 底层执行流: 在系统任务面板中,多路子代理并发执行 PDF 文档切片与实体提取。各章节由专属子代理完成深层证据链重构,最终由主 Agent 进行全局逻辑收敛与论证综合,确保综述正文中的每一项结论均具备可回溯的原文章节锚点。
范式三:【实验复现与报告撰写并进】基于 Async Research 的双线并发流水线
- 高阶任务指令示例:
“复现关于时间序列异常检测的基线算法。在云端沙盒中配置运行依赖、执行测试集评估并生成指标可视化图表;同时主线程同步撰写该算法的核心机理与消融实验分析报告。”
- 底层执行流: 主 Agent 在前台开展方法学推导与框架构建,后台异步子代理在隔离容器中自动化完成依赖安装、脚本运行与高精度图表渲染。完成事件触发后,图表资产以原子化方式注入主执行流,实现实验与撰写的无缝双线闭环。
5. 架构愿景:赋能严谨求实的科学探索
科学研究的本质是拓展人类认知的边界。每一位致力于严谨治学的学者,都深知文献沉淀、理论推导、代码复现与长程验证所伴随的工程艰辛。
技术工具的真正演进,绝不仅仅在于即时生成几段看似通顺的语言片段,而在于能否真正分担科研过程中冗长繁琐的工程负荷,消除数据孤岛与算力鸿沟。
LightRead 2.0 致力于成为每一位学者的自主研究智能体系统(Autonomous Research Agent System)——它具备横跨学术疆域的宽阔视野(Wide Research),具备自适应拓扑展开与自我反思的分布式协同架构(Agent Swarm),以及与本地设备生命周期彻底解耦的长程异步执行力(Async Research)。
将机械的数据搬运、繁重的文献切片、重复的沙盒配置与漫长的计算等待交给 LightRead,让学者的智识聚焦于真正具有创造性的核心假设、深刻洞察与科学发现。
立即访问 LightRead 2.0
- 学术工作区入口:https://lightingread.cn/
- 登录即可进入专属云端科研工作区,体验全生命周期的严肃科研协同新范式。